kafka配置
- 安装ZooKeeper
kafKa自带了ZooKeeper,也可以使用自带的启动;下面操作使用的即为自带的ZooKeeper; - 启动ZooKeeper ./bin/kafka-console-consumer.sh –bootstrap-server localhost:9092 –topic topiclj
bin/zookeeper-server-start.sh config/zookeeper.properties- 启动kafka
bin/kafka-server-start.sh config/server.properties- 查看是否启动成功
jps-l若启动成功,可以查看到如下语句:
kafka.Kafka
org.apache.zookeeper.server.quorum.QuorumPeerMain- 创建topic
bin/kafka-topics.sh --create --topic topicname --replication-factor 1 --partitions 1 --zookeeper localhost:2181- 创建producer
./bin/kafka-console-producer.sh --broker-list localhost:9092 --topic topiclj- 消费
./bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic topiclj定义
Kafka is a distributed streaming platform. This is a precise definition, let’s explain what is a streaming platform.
A streaming platform has three key capabilities:
- Publish and subscribe to streams of records, similar to a message queue or enterprise messaging system.
- Store streams of records in a fault-tolerant durable way.
- Process streams of records as they occur.
Kafka is generally used for two broad classes of applications:
- Building real-time streaming data pipelines that reliably get data between systems or applications
- Building real-time streaming applications that transform or react to the streams of data
Topics:
A topic is a category or feed name to which records are published. Topics in Kafka are always multi-subscriber; that is, a topic can have zero, one, or many consumers that subscribe to the data written to it.
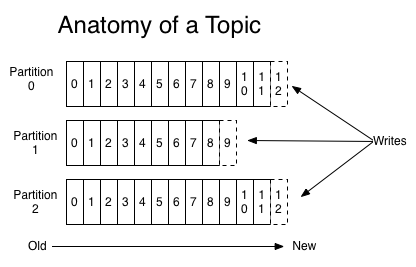
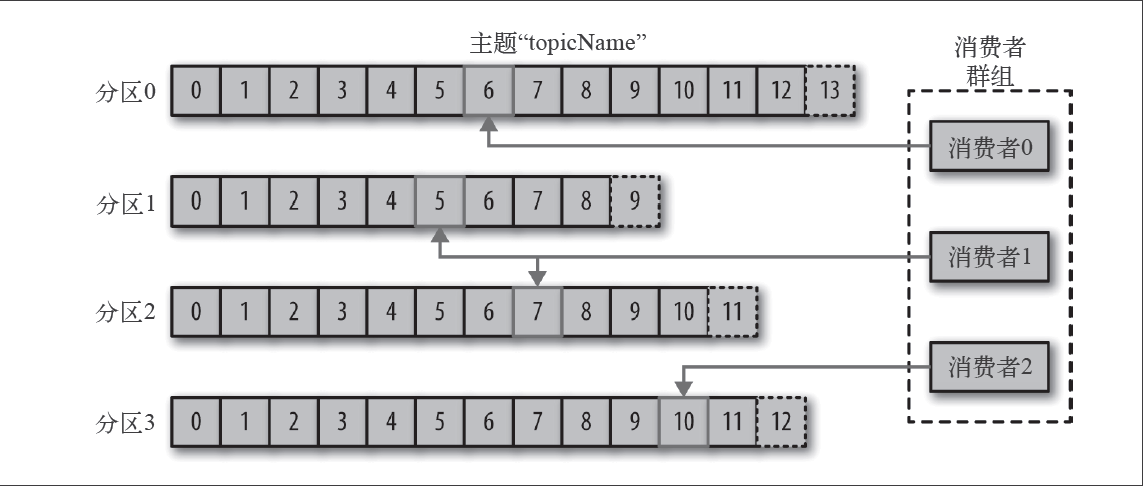
生产者既然在默认情况下把消息均匀的分布到不同的分区上去,而不关心特定的消息会被写到哪一个分区;
而消费者群组来保证一个分区的数据只能被一个消费者使用,那么,问题来了,怎么保证一个消费者可以拿到所需的全部数据呢?
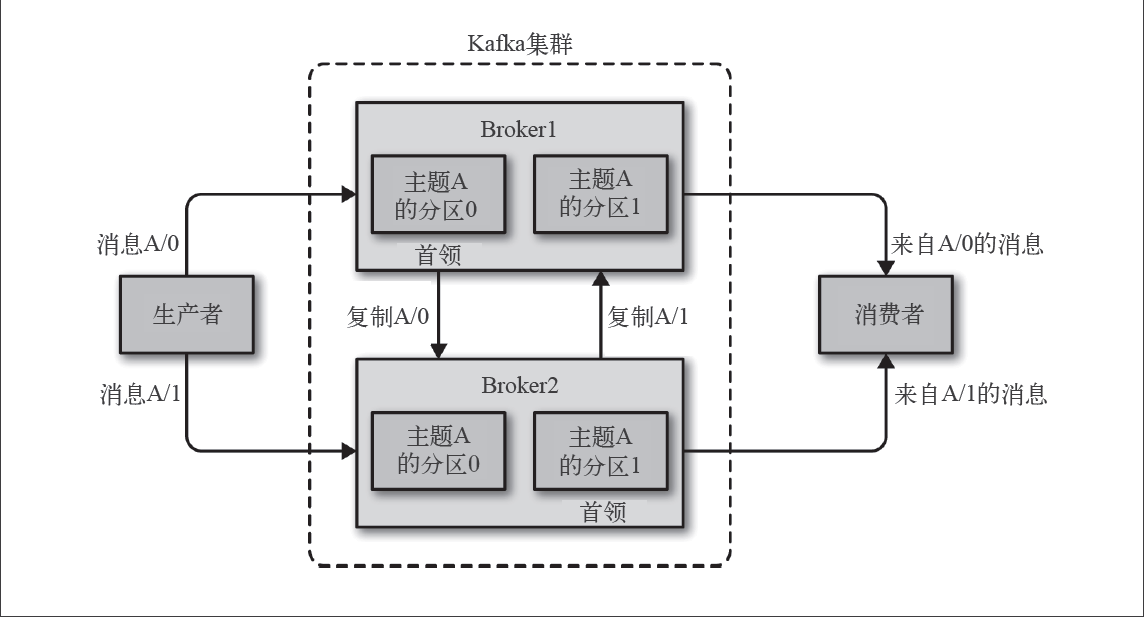
Kafka 的消息复制机制只能在单个集群里进行,不能在多个集群之间进行。
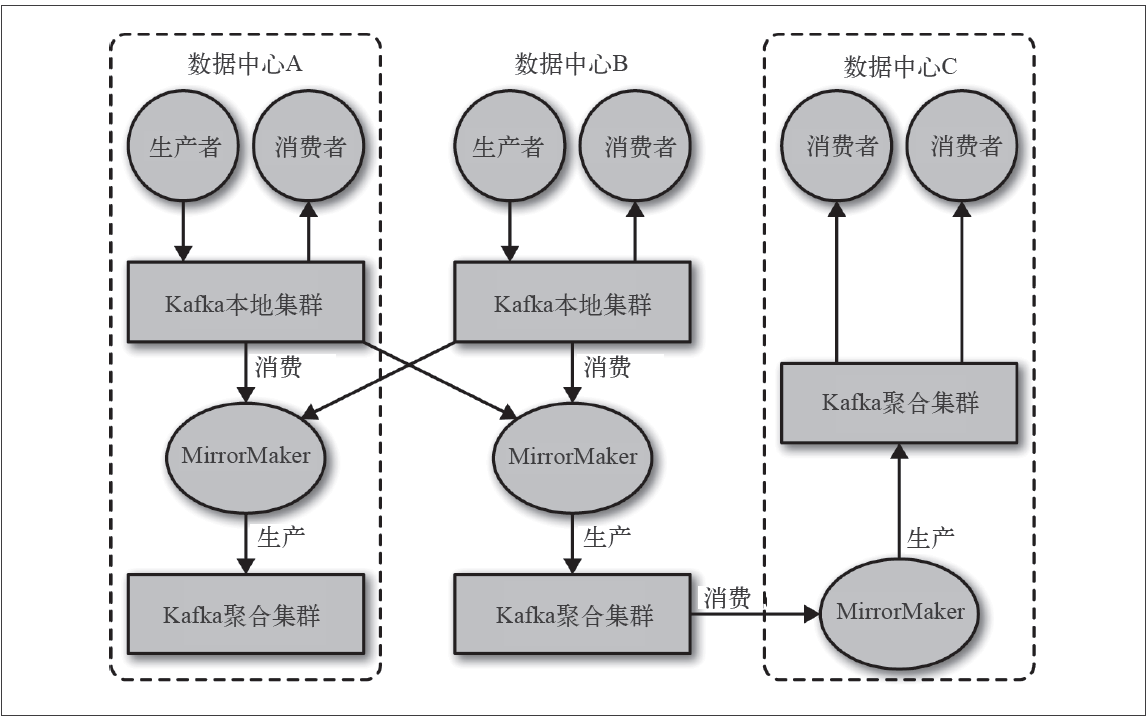
多数据中心架构
多个消费者可以组成一个群组,它们共享一个消息流,并保证整个群组对每个给定的消息只处理一次。
这样说明每个群组里面只有一个消费者可以消费到数据。
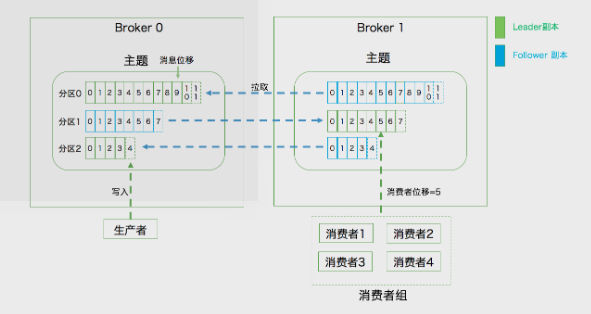
主题-分区
## 创建一个分区数为3,副本为1的一个topic:“topic-test”
./kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic topic-test
因为我们只设置了一个副本,并且我们只有一个broker;在/tmp/kafka-logs下面会有3个分区文件
topic-test-0
topic-test-1
topic-test-2
我们从zk上也能看到该主题的分区副本分配方案:
>> get /brokers/topics/topic-test
>> {"version":1,"partitions":{"2":[0],"1":[0],"0":[0]}}
“2”:[0] 表示分区2分配了1个副本,在brokerId为0的broker节点中。
# 展示主体信息(注意,zk的节点位置要写对)
bin/kafka-topics.sh --zookeeper localhost:2181/ --describe --topic topic-test
#结果如下:
Topic: topic-testPartition: 0Leader: 0Replicas: 0Isr: 0
Topic: topic-testPartition: 1Leader: 0Replicas: 0Isr: 0
Topic: topic-testPartition: 2Leader: 0Replicas: 0Isr: 0
主题
bin/kafka-topics.sh --bootstrap-server broker_host:port --create --topic my_topic_name --partitions 1 --replication-factor 1位移主题
一旦某个 Consumer Group 下的所有 Consumer 实例都停止了,而且它们的位移数据都已被删除时,Kafka 会向位移主题的对应分区写入 tombstone 消息,表明要彻底删除这个 Group 的信息。
分区
kafka的消息组织方式为:主题-分区-消息
分区是实现负载均衡以及高吞吐量的关键
Kafka 默认分区策略实际上同时实现了两种策略:如果指定了 Key,那么默认实现按消息键保序策略;如果没有指定 Key,则使用轮询策略。
生产者
事务生产者
发送消息主要有三种模式: 发后即忘(fire-and-forget)、 同步(sync)及异步(Casync)。
通常,我们只希望kafka对producer和consumer要处理的消息提供一定的承诺,即消息不被重复发送也不会丢失。
管理TCP连接
分区器
如果消息ProducerRecord中指定了 partition字段, 那么就不需要分区器作用, 因为partition代表的就是所要发往的分区号。如果消息ProducerRecord中没有 指定partition字段,那么就需要依赖分区器,根据key这个字段来计算partition的值。分区器的作用就是为消息 分配分区。
原理分析
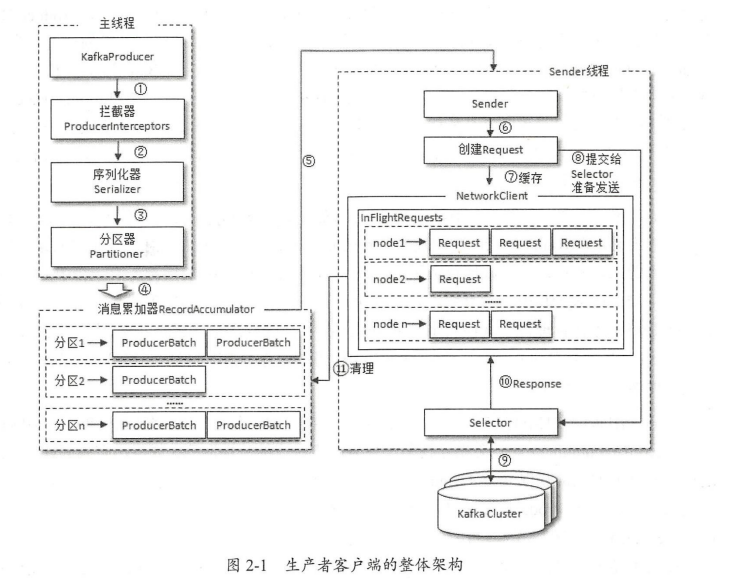
主线程中发送过来的消息都会被迫加到 RecordAccumulator 的某个双端队列( Deque )中,在 RecordAccumulator 的内部为每个分区都维护了一个双端队列,队列中的内容就是Producer Batch ,即 Deque。消息写入缓存时,追加到双端队列的尾部;Sender读取消息时 ,从双端队列的头部读取。
将较小的 ProducerRecord 拼凑成一个较大 的 ProducerBatch ,也可以减少网络请求的次数以提升整体的吞吐量。
元数据
我们使用如下的方式创建了一条消息 Producer Record:
ProducerRecord<String,String> record = new ProducerRecord<>(topic , ” Hello, Kafka !” ) ;我们只知道主题的名称,对于其他一些必要的信息却一无所知 。 KafkaProducer 要将此消息追加到指定主题的某个分区所对应的 leader 副本之前,首先需要知道主题的分区数量,然后经过计算得出(或者直接指定〉目标分区,之后 KafkaProducer 需要知道目标分区的 leader 副本所在的 broker 节点的地址、端口等信息才能建立连接,最终才能将消息发送到 Kafka ,在这一过程中所需要的信息都属于元数据信息。
当需要更新元数据时,会先挑选出 leastLoadedNode,然后向这个 Node 发送 MetadataRequest 请求来获取具体的元数据信息。这个更新操作是由 Sender线程发起 的, 在创 建完 MetadataRequest 之后 同样会存入 InF!ightRequests ,之后的 步骤就和发送消息时的类似 。 元数据虽然由 Sender 线程负责更新,但是主线程也需要读取这些信息,这里的数据同步通过 synchronized 和 final 关键字来保障。
重要的生产者参数
消费者组
Consumer Group 下所有实例订阅的主题的单个分区,只能分配给组内的某个 Consumer 实例消费。这个分区当然也可以被其他的 Group 消费。
Consumer Group 之间彼此独立,互不影响,它们能够订阅相同的一组主题而互不干涉。再加上 Broker 端的消息留存机制,Kafka 的 Consumer Group 完美地规避了上面提到的伸缩性差的问题。可以这么说,Kafka 仅仅使用 Consumer Group 这一种机制,却同时实现了传统消息引擎系统的两大模型:如果所有实例都属于同一个 Group,那么它实现的就是消息队列模型;如果所有实例分别属于不同的 Group,那么它实现的就是发布 / 订阅模型。
老版本的 Consumer Group 把位移保存在 ZooKeeper 中。Apache ZooKeeper 是一个分布式的协调服务框架,Kafka 重度依赖它实现各种各样的协调管理。将位移保存在 ZooKeeper 外部系统的做法,最显而易见的好处就是减少了 Kafka Broker 端的状态保存开销。现在比较流行的提法是将服务器节点做成无状态的,这样可以自由地扩缩容,实现超强的伸缩性。Kafka 最开始也是基于这样的考虑,才将 Consumer Group 位移保存在独立于 Kafka 集群之外的框架中。不过,慢慢地人们发现了一个问题,即 ZooKeeper 这类元框架其实并不适合进行频繁的写更新,而 Consumer Group 的位移更新却是一个非常频繁的操作。这种大吞吐量的写操作会极大地拖慢 ZooKeeper 集群的性能,因此 Kafka 社区渐渐有了这样的共识:将 Consumer 位移保存在 ZooKeeper 中是不合适的做法。
新版本的 Consumer Group 将位移保存在 Broker 端的内部主题中
重平衡
Rebalance 本质上是一种协议,规定了一个 Consumer Group 下的所有 Consumer 如何达成一致,来分配订阅 Topic 的每个分区。比如某个 Group 下有 20 个 Consumer 实例,它订阅了一个具有 100 个分区的 Topic。正常情况下,Kafka 平均会为每个 Consumer 分配 5 个分区。这个分配的过程就叫 Rebalance。
重平衡发生的时机:
- 组成员数发生变更。比如有新的 Consumer 实例加入组或者离开组,抑或是有 Consumer 实例崩溃被“踢出”组。订阅主题数发生变更。
- Consumer Group 可以使用正则表达式的方式订阅主题,比如 consumer.subscribe(Pattern.compile(“t.*c”)) 就表明该 Group 订阅所有以字母 t 开头、字母 c 结尾的主题。在 Consumer Group 的运行过程中,你新创建了一个满足这样条件的主题,那么该 Group 就会发生 Rebalance。
- 订阅主题的分区数发生变更。Kafka 当前只能允许增加一个主题的分区数。当分区数增加时,就会触发订阅该主题的所有 Group 开启 Rebalance。
重平衡保证了每个实例订阅的主题数大致相同,但在保证公平的同时,也会出现很多问题;
重平衡的问题:
在 Rebalance 过程中,所有 Consumer 实例都会停止消费,等待 Rebalance 完成。这是 Rebalance 为人诟病的一个方面。
重平衡能避免吗?
订阅主题的分区数发生变化以及订阅主题数量发生变化一般都是运维的主动操作,这类冲平衡不可避免。我们主要来说的是“组成员数量发生变化”这个原因。
如果 Consumer Group 下的 Consumer 实例数量发生变化,就一定会引发 Rebalance。这是 Rebalance 发生的最常见的原因。
Consumer 实例增加的情况很好理解,当我们启动一个配置有相同 group.id 值的 Consumer 程序时,实际上就向这个 Group 添加了一个新的 Consumer 实例。此时,Coordinator 会接纳这个新实例,将其加入到组中,并重新分配分区。通常来说,增加 Consumer 实例的操作都是计划内的,可能是出于增加 TPS 或提高伸缩性的需要。总之,它不属于我们要规避的那类“不必要 Rebalance”。
我们更在意的是 Group 下实例数减少这件事。如果你就是要停掉某些 Consumer 实例,那自不必说,关键是在某些情况下,Consumer 实例会被 Coordinator 错误地认为“已停止”从而被“踢出”Group。
当 Consumer Group 完成 Rebalance 之后,每个 Consumer 实例都会定期地向 Coordinator 发送心跳请求,表明它还存活着。如果某个 Consumer 实例不能及时地发送这些心跳请求,Coordinator 就会认为该 Consumer 已经“死”了,从而将其从 Group 中移除,然后开启新一轮 Rebalance。Consumer 端有个参数,叫 session.timeout.ms,就是被用来表征此事的。该参数的默认值是 10 秒,即如果 Coordinator 在 10 秒之内没有收到 Group 下某 Consumer 实例的心跳,它就会认为这个 Consumer 实例已经挂了。可以这么说,session.timeout.ms 决定了 Consumer 存活性的时间间隔。除了这个参数,Consumer 还提供了一个允许你控制发送心跳请求频率的参数,就是 heartbeat.interval.ms。这个值设置得越小,Consumer 实例发送心跳请求的频率就越高。
-
第一类非必要 Rebalance 是因为未能及时发送心跳,导致 Consumer 被“踢出”Group 而引发的。因此,你需要仔细地设置 session.timeout.ms 和 heartbeat.interval.ms 的值。
设置 session.timeout.ms = 6s。设置 heartbeat.interval.ms = 2s。
-
第二类非必要 Rebalance 是 Consumer 消费时间过长导致的。比如,在某个场景中,Consumer 消费数据时需要将消息处理之后写入到 MongoDB。显然,这是一个很重的消费逻辑。MongoDB 的一丁点不稳定都会导致 Consumer 程序消费时长的增加。此时,max.poll.interval.ms 参数值的设置显得尤为关键。如果要避免非预期的 Rebalance,你最好将该参数值设置得大一点,比你的下游最大处理时间稍长一点。就拿 MongoDB 这个例子来说,如果写 MongoDB 的最长时间是 7 分钟,那么你可以将该参数设置为 8 分钟左右。
segment消息
管理TCP连接
如果 Socket 不是在构造函数中创建的,那么是在 KafkaConsumer.subscribe 或 KafkaConsumer.assign 方法中创建的吗?严格来说也不是。我还是直接给出答案吧:TCP 连接是在调用 KafkaConsumer.poll 方法时被创建的。
通常来说,消费者程序会创建 3 类 TCP 连接:
- 确定协调者和获取集群元数据。
- 连接协调者,令其执行组成员管理操作。
- 执行实际的消息获取。
消费者
源码解析
从文末实战那一章节的我们能从实际的消费者代码看到,kafka消费主要是通过KafkaConsumer先订阅topic,然后通过poll方法进行消息拉取。
管理TCP连接
和生产者不同的是,构建 KafkaConsumer 实例时是不会创建任何 TCP 连接的;TCP 连接是在调用 KafkaConsumer.poll 方法时被创建的。再细粒度地说,在 poll 方法内部有 3 个时机可以创建 TCP 连接:
-
发起 FindCoordinator 请求时
当消费者程序首次启动调用 poll 方法时,它需要向 Kafka 集群发送一个名为 FindCoordinator 的请求,希望 Kafka 集群告诉它哪个 Broker 是管理它的协调者。在这一步,消费者会创建一个 Socket 连接。
-
连接协调者时
Broker 处理完上一步发送的 FindCoordinator 请求之后,会返还对应的响应结果(Response),显式地告诉消费者哪个 Broker 是真正的协调者,因此在这一步,消费者知晓了真正的协调者后,会创建连向该 Broker 的 Socket 连接。只有成功连入协调者,协调者才能开启正常的组协调操作,比如加入组、等待组分配方案、心跳请求处理、位移获取、位移提交等。
-
消费数据时
消费者会为每个要消费的分区创建与该分区领导者副本所在 Broker 连接的 TCP。举个例子,假设消费者要消费 5 个分区的数据,这 5 个分区各自的领导者副本分布在 4 台 Broker 上,那么该消费者在消费时会创建与这 4 台 Broker 的 Socket 连接。
这三类 TCP 请求的生命周期都是相同的吗?换句话说,这些 TCP 连接是何时被关闭的呢?
消费者关闭 Socket 也分为主动关闭和 Kafka 自动关闭。主动关闭是指你显式地调用消费者 API 的方法去关闭消费者,具体方式就是手动调用 KafkaConsumer.close() 方法,或者是执行 Kill 命令,不论是 Kill -2 还是 Kill -9;而 Kafka 自动关闭是由消费者端参数 connection.max.idle.ms 控制的,该参数现在的默认值是 9 分钟,即如果某个 Socket 连接上连续 9 分钟都没有任何请求“过境”的话,那么消费者会强行“杀掉”这个 Socket 连接。和生产者有些不同的是,如果在编写消费者程序时,你使用了循环的方式来调用 poll 方法消费消息,那么上面提到的所有请求都会被定期发送到 Broker,因此这些 Socket 连接上总是能保证有请求在发送,从而也就实现了“长连接”的效果。
当第三类 TCP 连接成功创建后,消费者程序就会废弃第一类 TCP 连接,之后在定期请求元数据时,它会改为使用第三类 TCP 连接。也就是说,最终你会发现,第一类 TCP 连接会在后台被默默地关闭掉。对一个运行了一段时间的消费者程序来说,只会有后面两类 TCP 连接存在。
多线程消费
KafkaConsumer 类不是线程安全的 (thread-safe)。所有的网络 I/O 处理都是发生在用户主线程中,因此,你在使用过程中必须要确保线程安全。简单来说,就是你不能在多个线程中共享同一个 KafkaConsumer 实例,否则程序会抛出 ConcurrentModificationException 异常。当然了,这也不是绝对的。KafkaConsumer 中有个方法是例外的,它就是 wakeup(),你可以在其他线程中安全地调用 KafkaConsumer.wakeup() 来唤醒 Consumer。
鉴于 KafkaConsumer 不是线程安全的事实,我们能够制定两套多线程方案。
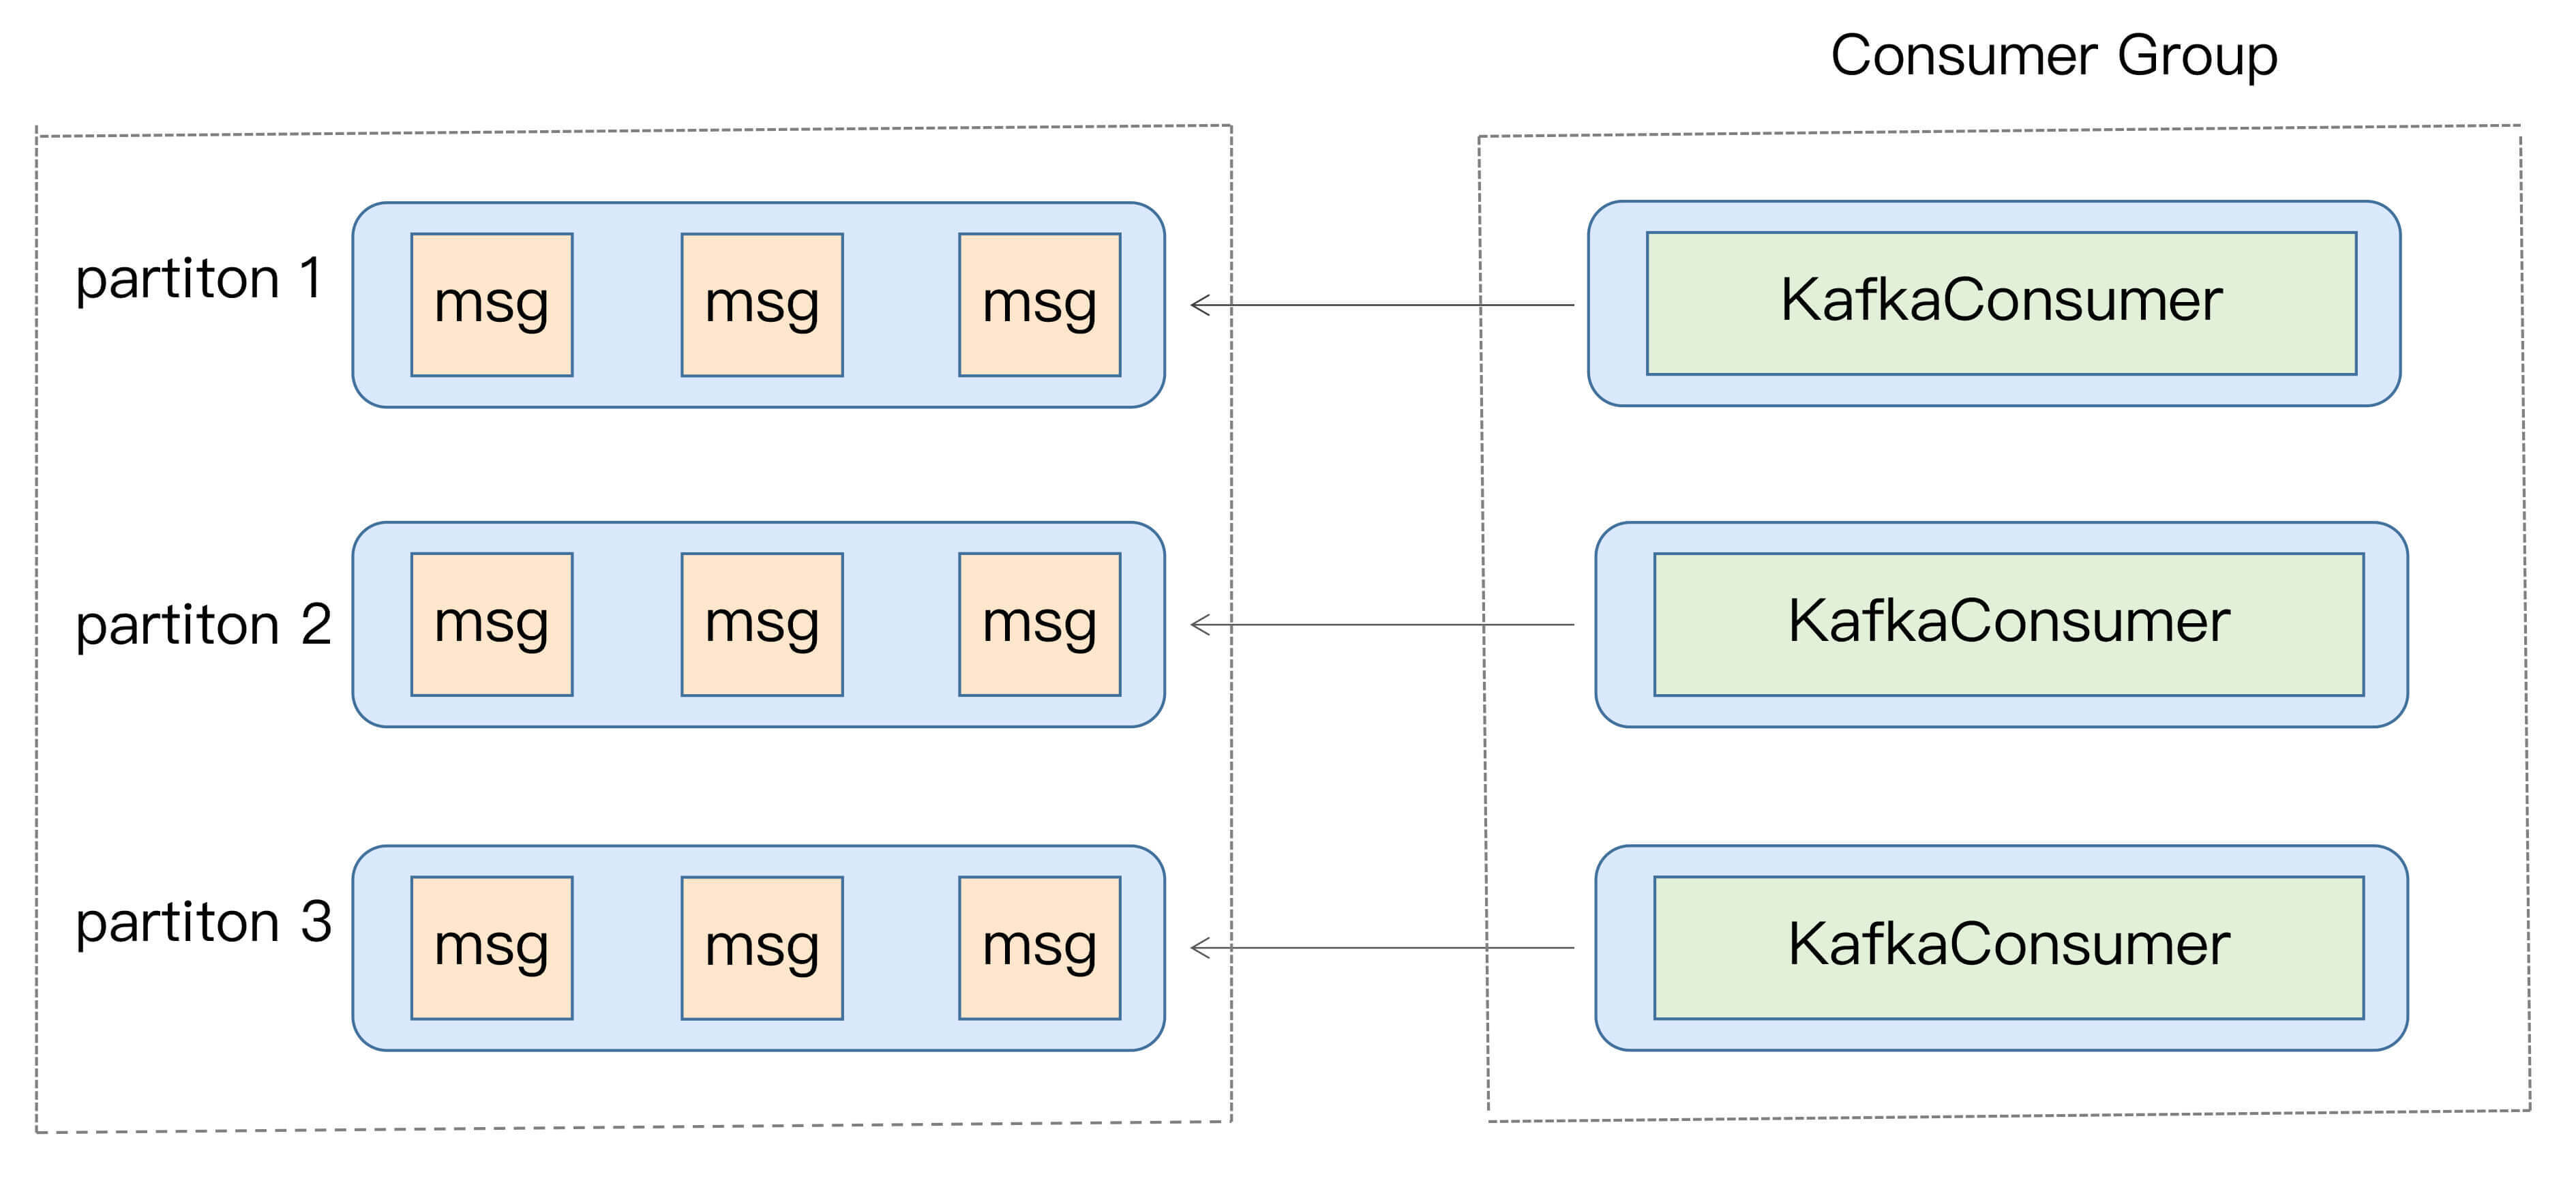
- 消费者程序启动多个线程,每个线程维护专属的 KafkaConsumer 实例,负责完整的消息获取、消息处理流程。
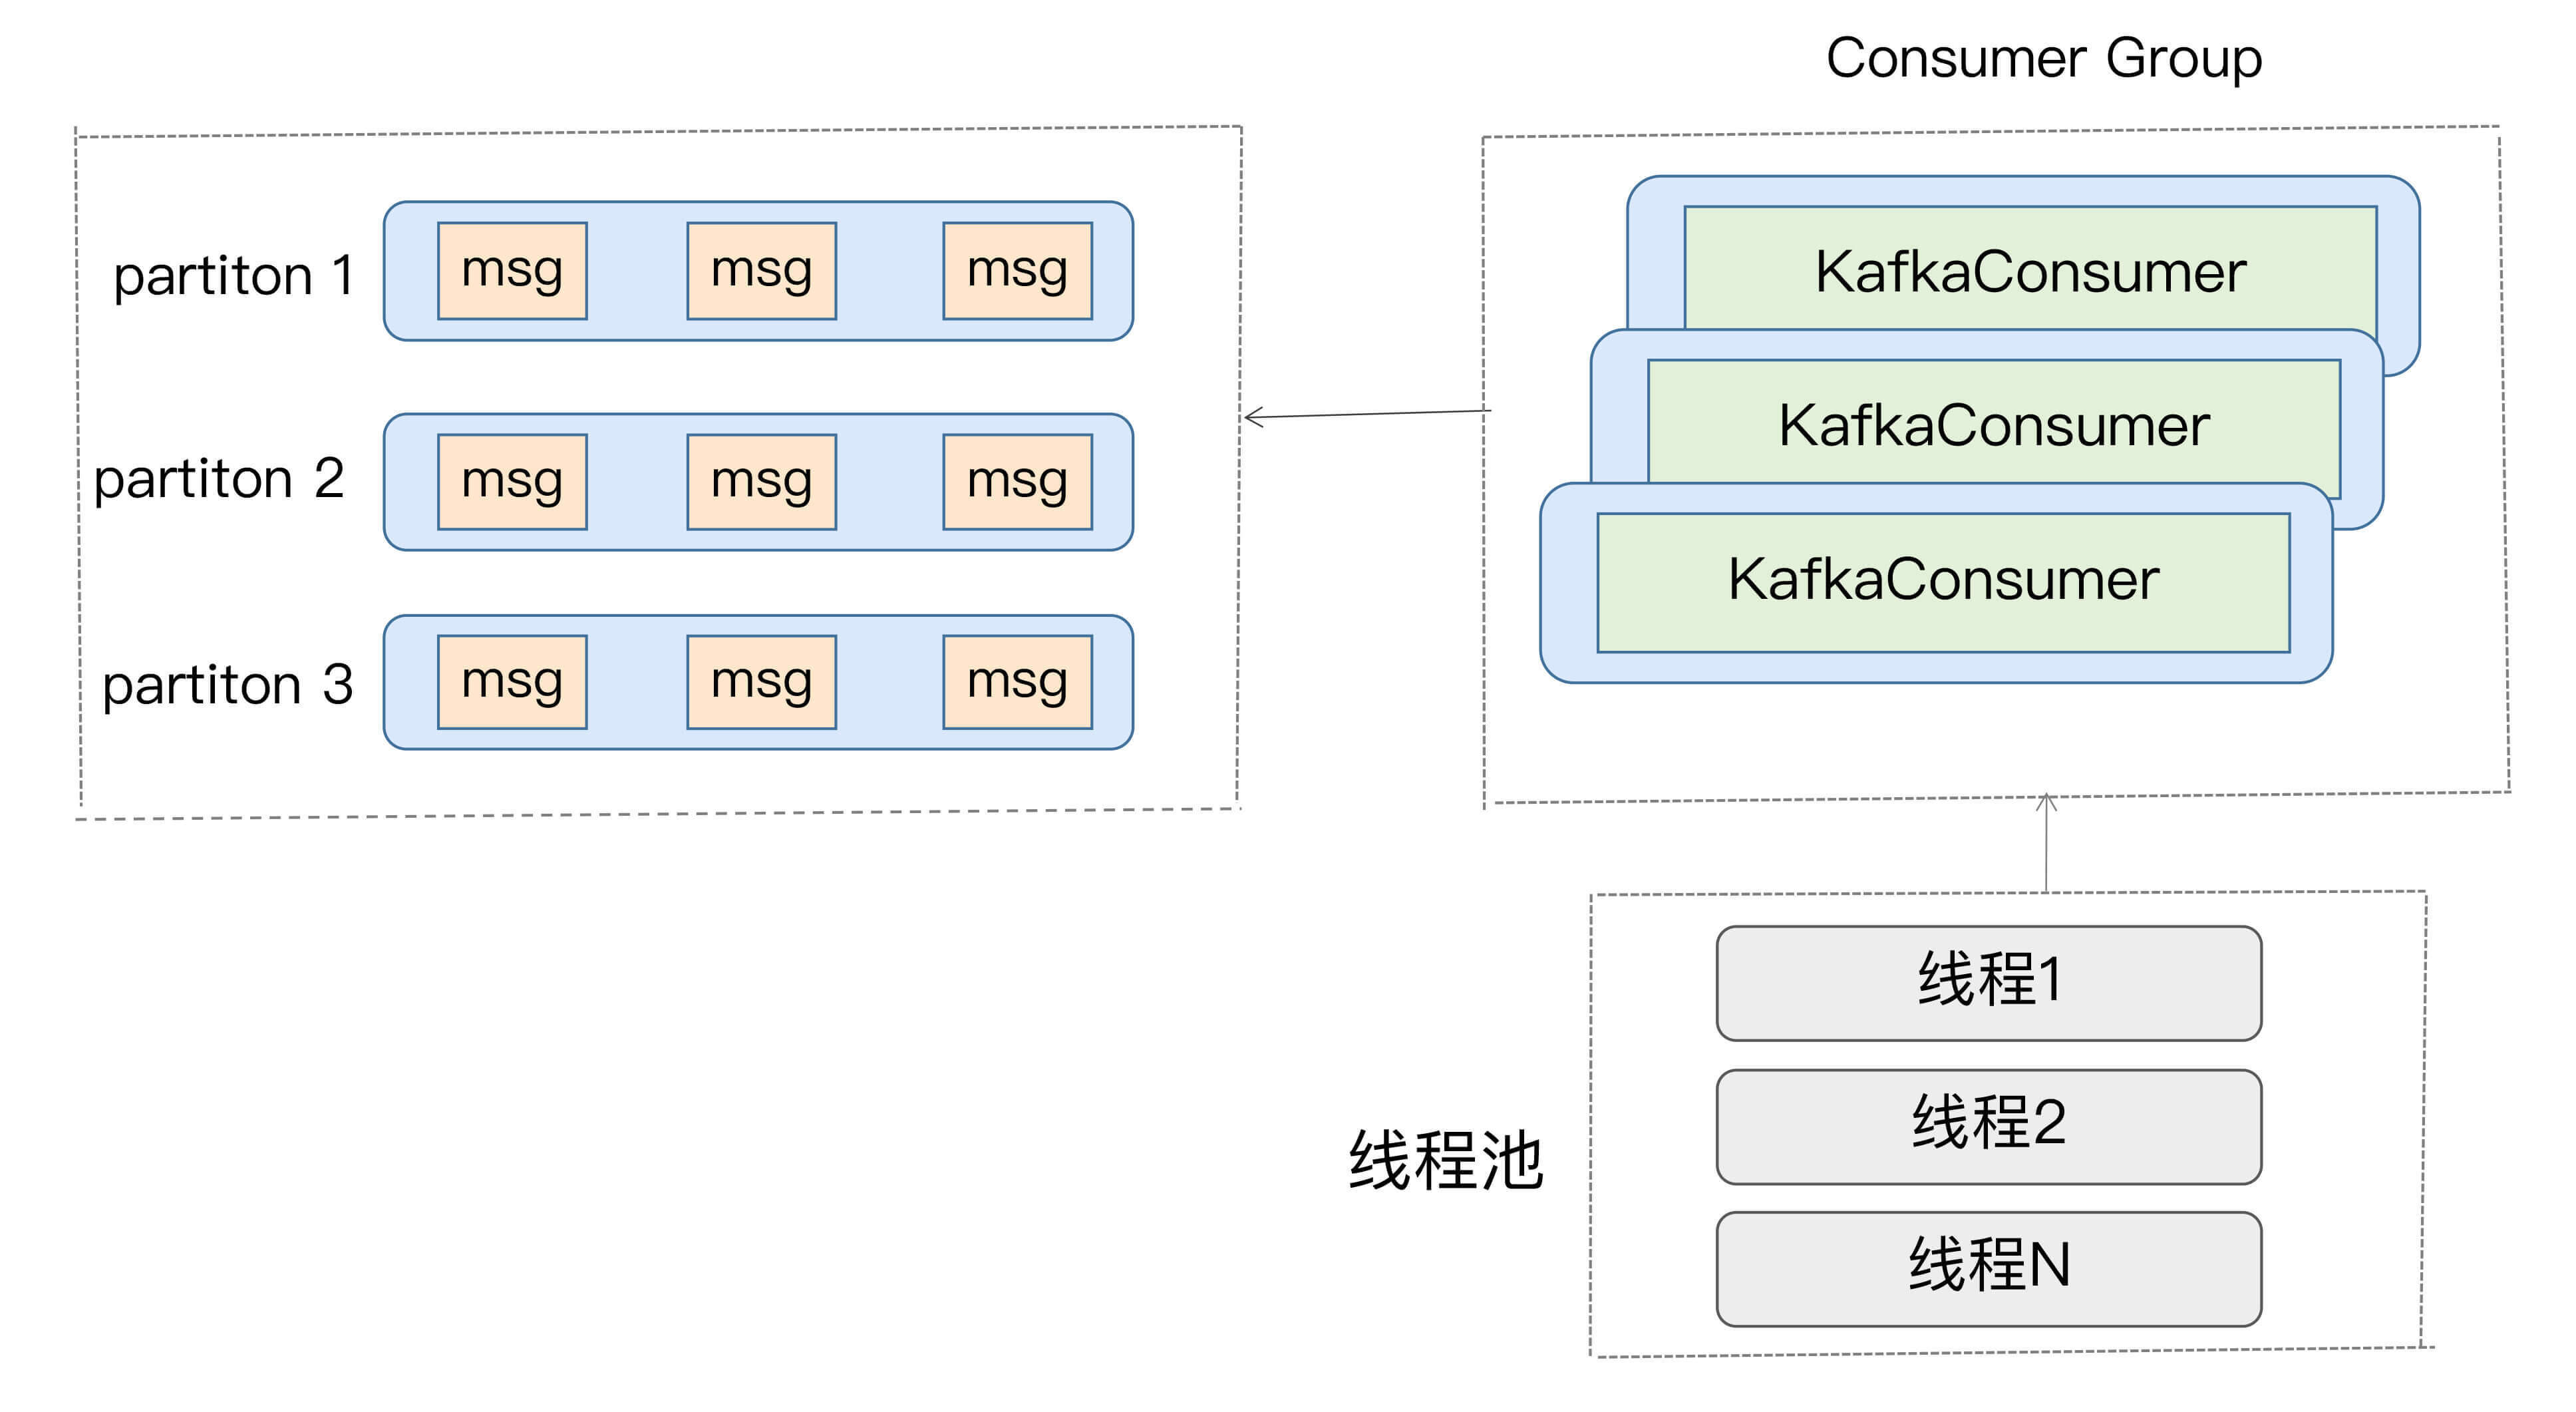
- 消费者程序使用单或多线程获取消息,同时创建多个消费线程执行消息处理逻辑。获取消息的线程可以是一个,也可以是多个,每个线程维护专属的 KafkaConsumer 实例,处理消息则交由特定的线程池来做,从而实现消息获取与消息处理的真正解耦。
对于1方案,由于每个线程使用专属的 KafkaConsumer 实例来执行消息获取和消息处理逻辑,因此,Kafka 主题中的每个分区都能保证只被一个线程处理,这样就很容易实现分区内的消息消费顺序。这对在乎事件先后顺序的应用场景来说,是非常重要的优势。
但是,1方案中每个线程都维护自己的 KafkaConsumer 实例,必然会占用更多的系统资源,比如内存、TCP 连接等。
方案 2 将任务切分成了消息获取和消息处理两个部分,分别由不同的线程处理它们。比起方案 1,方案 2 的最大优势就在于它的高伸缩性,就是说我们可以独立地调节消息获取的线程数,以及消息处理的线程数,而不必考虑两者之间是否相互影响。
但是,因为该方案将消息获取和消息处理分开了,也就是说获取某条消息的线程不是处理该消息的线程,因此无法保证分区内的消费顺序。举个例子,比如在某个分区中,消息 1 在消息 2 之前被保存,那么 Consumer 获取消息的顺序必然是消息 1 在前,消息 2 在后,但是,后面的 Worker 线程却有可能先处理消息 2,再处理消息 1,这就破坏了消息在分区中的顺序。还是那句话,如果你在意 Kafka 中消息的先后顺序,方案 2 的这个劣势是致命的。还有,方案 2 引入了多组线程,使得整个消息消费链路被拉长,最终导致正确位移提交会变得异常困难,结果就是可能会出现消息的重复消费。如果你在意这一点,那么我不推荐你使用方案 2。
方案1的实现:
public class KafkaConsumerRunner implements Runnable {
     private final AtomicBoolean closed = new AtomicBoolean(false);
     private final KafkaConsumer consumer;


     public void run() {
         try {
             consumer.subscribe(Arrays.asList("topic"));
             while (!closed.get()) {
      ConsumerRecords records =
        consumer.poll(Duration.ofMillis(10000));
                 //  执行消息处理逻辑
             }
         } catch (WakeupException e) {
             // Ignore exception if closing
             if (!closed.get()) throw e;
         } finally {
             consumer.close();
         }
     }
     // Shutdown hook which can be called from a separate thread
     public void shutdown() {
         closed.set(true);
         consumer.wakeup();
     }
}
此段代码创建了一个 Runnable 类,表示执行消费获取和消费处理的逻辑。每个 KafkaConsumerRunner 类都会创建一个专属的 KafkaConsumer 实例。在实际应用中,你可以创建多个 KafkaConsumerRunner 实例,并依次执行启动它们,以实现方案 1 的多线程架构。
方案2的代码:
private final KafkaConsumer<String, String> consumer;
private ExecutorService executors;
...


private int workerNum = ...;
executors = new ThreadPoolExecutor(
  workerNum, workerNum, 0L, TimeUnit.MILLISECONDS,
  new ArrayBlockingQueue<>(1000),
  new ThreadPoolExecutor.CallerRunsPolicy());


...
while (true)  {
  ConsumerRecords<String, String> records =
    consumer.poll(Duration.ofSeconds(1));
  for (final ConsumerRecord record : records) {
    executors.submit(new Worker(record));
  }
}
..
这段代码最重要的地方是最后一行:当 Consumer 的 poll 方法返回消息后,由专门的线程池来负责处理具体的消息。调用 poll 方法的主线程不负责消息处理逻辑,这样就实现了方案 2 的多线程架构。
消费进度监控
kafka自带命令
$ bin/kafka-consumer-groups.sh --bootstrap-server <Kafka broker连接信息> --describe --group <group名称>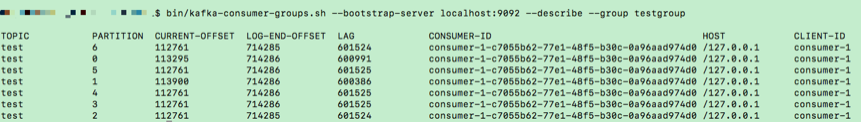
其中,LAG 值(前两者的差值)就是生产者最新的数据和消费者最新消费的数据之间的差值
控制器
职责
负责管理整个集群中所有 分区 和副本的状态。 当某个分区的leader副本出现故障时, 由控制器负责为该分区选举 新的 leader副本。 当检测到某个分区的 ISR集合发生变化时,由控制器负责通知所有broker更 新其元数据信息。当使用kafka-to pics.sh脚本为某个topic增加分区数量时, 同样还是由控制器负责 分区的重新分配。
协调器
原本kafka是基于zk来实现协调器的;这种方式下 每个消费者 对ZooKeeper的相关路径 分别进行监听,当触发再均衡操作时, 一个消费组下的所有消费者会 同时进行再均衡操作,而消费者之间并不知道彼此操作的结果,这样可能导致Kafka工作在 一 个不正确的状态。与 此同时,这种严重依赖于ZooKeeper集群的做法还有两个比较严重的问题 。
- 羊群效应(Herd Effect) : 所谓的羊群效应是指ZooKeeper中 一 个被监听的节点变化,大量的Watcher 通知被发送到客户端,导致在通知期间的其他操作延迟 , 也有可能 发生类似死锁的情况 。
- 脑裂问题 (Split Brain) : 消费者进行再均衡操作时每个消费者都与ZooKeeper进行通信以判断消费者或 broker变化的情况,由于ZooKeeper本身的特性, 可能导致在同 一 时刻各个消费者获取的状态不 一 致,这样会导致异常问题发生 。
新版的消费者客户端对此进行了重新设计,将全部消费组分成多个子集, 每个消费组的子集在服务端对应一个GroupCoordinator对其进行管理,GroupCoordinator是Kaflca服务端中用于管理消费组的组件。而消费者客户端中的 ConsumerCoordinator组件负责与GroupCoordinator进行交互。
一. FIND_COORDINATOR
消费者需要确定它所属的消费组对应的GroupCoordinator所在的 broker, 并创建与该broker相互通信的网络连接 。如果消费者已经保存了与消费组对应的 GroupCoordinator 节点的信息,并且与它之间的网络连接是正常的,那么就可以进入第二阶段。否则, 就需要向集群中的某个节点发送FindCoordi na to rRequest请求来查找对应的GroupCoordinator,这里的 某个节点并非是集群中的任意节点,而是负载最小的节点。
Kafka 在收到 FindCoordinator Request 请求 之后,会根据coordinator_key (也就是groupld)查找对应的GroupCoordinator节点,如果找到对应的GroupCoordinator则会返回其相对应的 node_id、host和port信息。
具体查找GroupCoordinator的方式是先根据消费组Groupld的哈希值计算_consumer—offsets中的分区编号:
Utils.abs(groupid.hashCode) % groupMetadataTopicPartitionCount其中groupid.hashCode就是使用Java 中String类的 hashCode()方法获得的,groupMetadataTopicPart itionCount为主题—consumer _offsets 的分区个数,这个可以通过broker端参数 offsets.topic.num.parti巨ons来配 置,默认值为50。
找到对应的_consumer_offsets中的分区之后,再寻找 此分区leader副本所在的broker节点,该broker节点即为这个 groupld 所对应的GroupCoordinator节点 。消费者 groupld最终的分区分配方案及组内消费者所提交的消费位移信息都会发送给此分区leader副本所在的broker节点,让此broker节点既扮演GroupCoordinator 的角色,又扮演保存分区分配方案和组内消费者位移的角色,这样可以省去很多不必要的中间轮转所带来的开销。
二.JOIN_GROUP
在成功找到 消费组所对应的GroupCoordinator之后就进入加入消费组的阶段,在此阶段 的消费者会向GroupCoordinator发送JoinGroupRequest请求,并处理响应。
选举出分区分配策略;
三. SYNC GROUP
leader 消 费者根据在第 二 阶段中选 举 出 来的分区分配策略来实施具体的分区分配,在此之后需要将分配的方案同步给各个消费者,此时 leader 消费者并不是直接和其余的普通消费者同步分配方案,而是通过 GroupCoordinator 这个“中间人”来负 责 转发同步分配方案的 。 在第 三阶段,也就是同步阶段, 各个消 费者会 向 GroupCoordinator 发送 SyncGroupRequest 请求来同步分配方案。
持久化
Kafka直接将数据写入到日志文件中,以追加的形式写入。
操作
解压log文件
# 查看log文件
bin/kafka-run-class.sh kafka.tools.DumpLogSegments --files /tmp/kafka-logs/test-topic-0/00000000000000000000.log  --print-data-log
# 查看timeindex文件
bin/kafka-run-class.sh kafka.tools.DumpLogSegments --files /tmp/kafka-logs/test-topic-0/00000000000000000000.timeindex
# 查看index文件
bin/kafka-run-class.sh kafka.tools.DumpLogSegments --files /tmp/kafka-logs/test-topic-0/00000000000000000000.index
日志索引
Kafka 中的索引文件以稀疏索引( sparse index )的方式构造消息的索引,它并不保证每个消息在索引文件中都有对应的索引 每当写入一定量(由 broker 端参数 log.index.interval.bytes 指定,默认值为 4096 ,即 4KB )的消息时,偏移量索引文件和时间戳索引文件分别增加一个偏移量索引项和时间戳索引项,增大或减小 log.index . .i,.nterval.bytes 的值,对应地可以增加或缩小索引项的密度。
稀疏索引通过 MappedByteBuffer 将索引文件映射到内存中,以加快索引的查询速度。偏移量索引文件中的偏移量是单调递增的,查询指定偏移量时,使用二分查找法来快速定位偏移量的位置,如果指定的偏移量不在索引文件中,则会返回小于指定偏移量的最大偏移量 时间戳索引文件中的时间戳也保持严格的单调递增,查询指定时间戳时,也根据二分查找法来查找不大于该时间戳的最大偏移量,至于要找到对应的物理文件位置还需要根据偏移量索引文件来进行再次定位。稀疏索引的方式是在磁盘空间、内存空间、查找时间等多方面之间的一个折中。
磁盘存储
kafka使用磁盘存储信息,而在传统的消息中间件RabbitMQ中, 使用内存作为默认的存储介质, 而磁盘作为备选介质, 以此实现高吞吐和低延迟的特性。 然而, 事实上磁盘可以比我们预想的要快, 也可能比我们预想的要慢, 这完全取决于我们如何使用它。
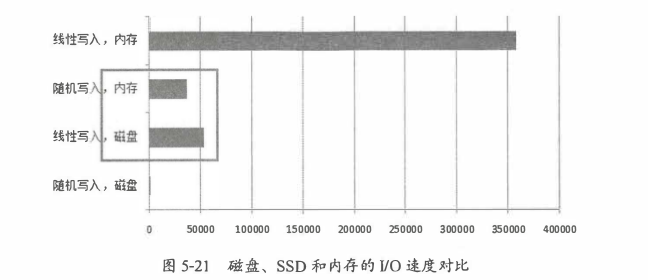
Kafka 在设计时采用了文件追加的方式来写入消息, 即只能在日志文件的尾部追加新的消息, 并且也不允许修改己写入的消息, 这种方式属于典型的顺序写盘的操作, 所以就算Kafka使用磁盘作为存储介质, 它所能承载的吞吐量也不容小觑。
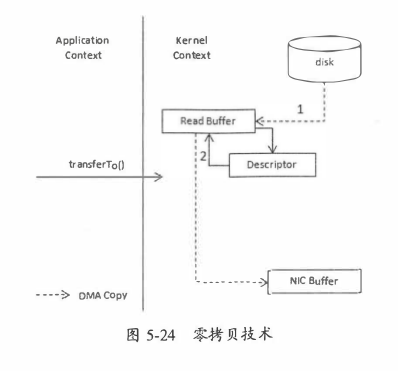
除了消息追加,kafka还使用了页缓存技术和零拷贝技术。
位移
新版本 Consumer 的位移管理机制其实也很简单,就是将 Consumer 的位移数据作为一条条普通的 Kafka 消息,提交到 consumer_offsets 中。可以这么说,consumer_offsets 的主要作用是保存 Kafka 消费者的位移信息。
位移主题的 Key 中应该保存 3 部分内容:
Kafka 使用 Compact 策略来删除位移主题中的过期消息,避免该主题无限期膨胀。
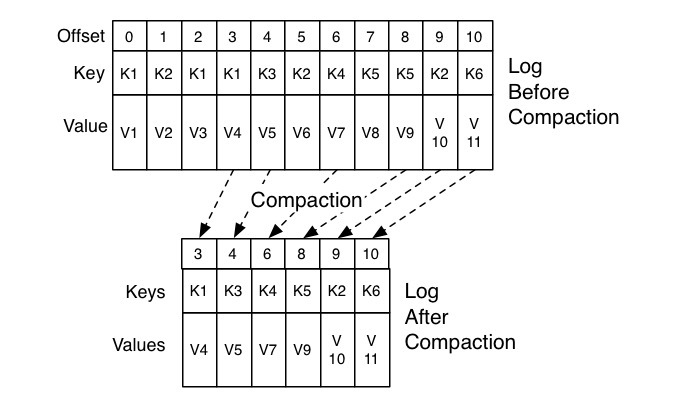
Kafka 提供了专门的后台线程定期地巡检待 Compact 的主题,看看是否存在满足条件的可删除数据。这个后台线程叫 Log Cleaner。很多实际生产环境中都出现过位移主题无限膨胀占用过多磁盘空间的问题,如果你的环境中也有这个问题,我建议你去检查一下 Log Cleaner 线程的状态,通常都是这个线程挂掉了导致的。
位移提交
从用户的角度来说,位移提交分为自动提交和手动提交;从 Consumer 端的角度来说,位移提交分为同步提交和异步提交。
自动提交比较简单,Consumer 端有个参数 enable.auto.commit,把它设置为 true 或者压根不设置它就可以了。
手动提交需要调用相应的 API 手动提交位移;
while (true) {
            ConsumerRecords<String, String> records =
                        consumer.poll(Duration.ofSeconds(1));
            process(records); // 处理消息
            try {
                        consumer.commitSync();
            } catch (CommitFailedException e) {
                        handle(e); // 处理提交失败异常
            }
}
我们分别分析下这两种提交方式:
- 在默认情况下,Consumer 每 5 秒自动提交一次位移。现在,我们假设提交位移之后的 3 秒发生了 Rebalance 操作。在 Rebalance 之后,所有 Consumer 从上一次提交的位移处继续消费,但该位移已经是 3 秒前的位移数据了,故在 Rebalance 发生前 3 秒消费的所有数据都要重新再消费一次。虽然你能够通过减少 auto.commit.interval.ms 的值来提高提交频率,但这么做只能缩小重复消费的时间窗口,不可能完全消除它。这是自动提交机制的一个缺陷。
- 手动提交位移,它的好处就在于更加灵活,你完全能够把控位移提交的时机和频率。但是,它也有一个缺陷,就是在调用 commitSync() 时,Consumer 程序会处于阻塞状态,直到远端的 Broker 返回提交结果,这个状态才会结束。在任何系统中,因为程序而非资源限制而导致的阻塞都可能是系统的瓶颈,会影响整个应用程序的 TPS。
鉴于这个问题,社区设计了一个新的api方法:KafkaConsumer#commitAsync()
其是异步提交的,不会阻塞。但是这个api有没有问题呢?答案是有。commitAsync 的问题在于,出现问题时它不会自动重试。因为它是异步操作,倘若提交失败后自动重试,那么它重试时提交的位移值可能早已经“过期”或不是最新值了。因此,异步提交的重试其实没有意义,所以 commitAsync 是不会重试的。
如果我们既不想程序总是处于阻塞状态,又想利用commitSync 的自动重试来规避那些瞬时错误,比如网络的瞬时抖动,Broker 端 GC 等。那么我们只能将commitSync和commitAsync结合起来用了。
try {
    while(true) {
        ConsumerRecords<String, String> records = consumer.poll(Duration.ofSeconds(1));
        process(records); // 处理消息
        commitAysnc(); // 使用异步提交规避阻塞
    }
} catch(Exception e) {
handle(e); // 处理异常
} finally {
try {
    consumer.commitSync(); // 最后一次提交使用同步阻塞式提交
} finally {
       consumer.close();
}
}
很多时候,我们希望将一个大事务分割成若干个小事务分别提交,这能够有效减少错误恢复的时间。kafka Consumer API 为手动提交提供了这样的方法:commitSync(Map) 和 commitAsync(Map)。它们的参数是一个 Map 对象,键就是 TopicPartition,即消费的分区,而值是一个 OffsetAndMetadata 对象,保存的主要是位移数据。
private Map<TopicPartition, OffsetAndMetadata> offsets = new HashMap<>();
int count = 0;
……
while (true) {
    ConsumerRecords<String, String> records = consumer.poll(Duration.ofSeconds(1));
    for (ConsumerRecord<String, String> record: records) {
        process(record);  // 处理消息
        offsets.put(new TopicPartition(record.topic(), record.partition()),
                new OffsetAndMetadata(record.offset() + 1);
        if(count % 100 == 0)
        consumer.commitAsync(offsets, null); // 回调处理逻辑是null
        count++;
    }
}
位移提交的错误处理
Commit cannot be completed since the group has already rebalanced and assigned the partitions to another member. This means that the time between subsequent calls to poll() was longer than the configured max.poll.interval.ms, which typically implies that the poll loop is spending too much time message processing. You can address this either by increasing max.poll.interval.ms or by reducing the maximum size of batches returned in poll() with max.poll.records.
上述异常表明位移提交出现了异常。
我们先说说最常见的场景。当消息处理的总时间超过预设的 max.poll.interval.ms 参数值时,Kafka Consumer 端会抛出 CommitFailedException 异常。这是该异常最“正宗”的登场方式。
要防止这种场景下抛出异常,你需要简化你的消息处理逻辑。具体来说有 4 种方法。
- 缩短单条消息处理的时间。比如,之前下游系统消费一条消息的时间是 100 毫秒,优化之后成功地下降到 50 毫秒,那么此时 Consumer 端的 TPS 就提升了一倍。
- 增加 Consumer 端允许下游系统消费一批消息的最大时长。这取决于 Consumer 端参数 max.poll.interval.ms 的值。在最新版的 Kafka 中,该参数的默认值是 5 分钟。如果你的消费逻辑不能简化,那么提高该参数值是一个不错的办法。
- 减少下游系统一次性消费的消息总数。这取决于 Consumer 端参数 max.poll.records 的值。当前该参数的默认值是 500 条,表明调用一次 KafkaConsumer.poll 方法,最多返回 500 条消息。可以说,该参数规定了单次 poll 方法能够返回的消息总数的上限。如果前两种方法对你都不适用的话,降低此参数值是避免 CommitFailedException 异常最简单的手段。
- 下游系统使用多线程来加速消费。这应该算是“最高级”同时也是最难实现的解决办法了。具体的思路就是,让下游系统手动创建多个消费线程处理 poll 方法返回的一批消息。之前你使用 Kafka Consumer 消费数据更多是单线程的,所以当消费速度无法匹及 Kafka Consumer 消息返回的速度时,它就会抛出 CommitFailedException 异常。如果是多线程,你就可以灵活地控制线程数量,随时调整消费承载能力,再配以目前多核的硬件条件,该方法可谓是防止 CommitFailedException 最高档的解决之道。事实上,很多主流的大数据流处理框架使用的都是这个方法,比如 Apache Flink 在集成 Kafka 时,就是创建了多个 KafkaConsumerThread 线程,自行处理多线程间的数据消费。不过,凡事有利就有弊,这个方法实现起来并不容易,特别是在多个线程间如何处理位移提交这个问题上,更是极容易出错。
除此之外,如果你的应用 中同时出现了设置相同 group.id 值的消费者组程序和独立消费者程序,那么当独立消费者程序手动提交位移时,Kafka 就会立即抛出 CommitFailedException 异常,因为 Kafka 无法识别这个具有相同 group.id 的消费者实例,于是就向它返回一个错误,表明它不是消费者组内合法的成员
zookeeper in kafka
-
Controller Election
集群中第一个启动的broker会通过在zookeeper中创建临时节点
/controller来让自己成为控制器,其他broker启动时也会在zookeeper中创建临时节点,但是发现节点已经存在,所以它们会收到一个异常,意识到控制器已经存在,那么就会在zookeeper中创建watch对象,便于它们收到控制器变更的通知。 -
Topic Configuration
ZooKeeper maintains the configuration of all topics, including the list of existing topics, number of partitions for each topic, location of the replicas, configuration overrides for topics, preferred leader node, among other details.
[zk: 127.0.0.1:2181(CONNECTED) 13] ls /brokers [ids, topics, seqid] [zk: 127.0.0.1:2181(CONNECTED) 14] ls /brokers/ids [0] [zk: 127.0.0.1:2181(CONNECTED) 15] ls /brokers/topics [topic-test, __consumer_offsets] [zk: 127.0.0.1:2181(CONNECTED) 16] ls /brokers/seqid [] ----------- [zk: 127.0.0.1:2181(CONNECTED) 22] ls /brokers/topics/__consumer_offsets/partitions [44, 45, 46, 47, 48, 49, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43] [zk: 127.0.0.1:2181(CONNECTED) 23] ls /brokers/topics/topic-test/partitions [0] -
Access Control Lists (ACLs). ZooKeeper also maintains the ACLs for all topics. This includes who or what is allowed to read/write to each topic, list of consumer groups, members of the groups, and the most recent offset each consumer group received from each partition.
实战
增值项目中的kafka
生产者代码
public class NewKafka {
    private static Producer<String, String> newProducer;

    public static void open() {
        if (newProducer == null) {
            Properties props = new Properties();
            props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, BConfiguration.getProperty(BConstants.KAFKA_BOOTSTRAP_SERVERS));
            props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
            props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
            props.put(ProducerConfig.ACKS_CONFIG, "-1");
            newProducer = new KafkaProducer<String, String>(props);
        }
    }

    public static void close() {
        try {
            if (newProducer != null) {
                newProducer.close();
                newProducer = null;
            }
        } catch (Exception e) {
            newProducer = null;
            Loggers.logApiError(e);
        }
    }

    public static boolean send(String topic, String message) {
        try {
            if (newProducer == null) {
                open();
            }
            newProducer.send(new ProducerRecord<String, String>(topic, message));
            Loggers.logApiMonitor("NewKafka Send message: " + message);
            return true;
        } catch (Exception e) {
            Loggers.logApiMonitor("NewKafka Failed to Send message: " + message);
            Loggers.logApiError(e);
            return false;
        }
    }
}
消费者代码
@PostConstruct
public void startConsumer() {
    try {
        KafkaMessageCallback callback = new KafkaMessageCallback() {
            @Override
            public void process(Event event) {

                switch (event.getType()) {
                    case Event.TYPE_INI:
                        iniService.refresh(event);
                        break;
                    case Event.TYPE_PRICETAGPAGE_GROUPTYPE:
                        userGroupService.refreshGroupTypeInfo(event);
                        break;
                    case Event.TYPE_PRICETAGPAGE_WHITE_LIST:
                        userGroupService.refreshWhiteList(event);
                        break;
                    case Event.TYPE_PROMOTION_ACTIVITY_OLD:
                        productDonateService.refresh(event);
                        promotionPriceService.refresh(event);
                        break;
                    case Event.TYPE_PROMOTION_PRICE:
                        promotionPriceService.refresh(event);
                        break;
                    case Event.TYPE_PICTURE:
                        pictureConfigService.refreshCommonImage(event);
                        break;
                    case Event.TYPE_PRICETAGPAGE_BACKGROUND:
                        adminConfigService.refreshUrl(event);
                        break;
                    case Event.TYPE_PRICETAGPAGE_PRODUCT:
                        adminConfigService.refreshProductConfig(event);
                        break;
                    case Event.TYPE_MARKETING_PRICE_PAGE:
                        marketingPricePageService.refreshConfigMap(event);
                        break;
                    case Event.TYPE_PRICE_PAGE:
                        pricePageConfigDataService.refreshConfigMap(event);
                        break;
                    default:
                        break;
                }
            }
        };
        KafkaConsumerConfig config = KafkaConsumerConfig.builder()
            .autoCommitInterval(autoCommitInterval)
            .kafakaBootstrapServers(kafakaBootstrapServers)
            .kafakaRootpath(kafakaRootpath).topic(TOPIC)
            .groupId(groupId).groupIdPrefix(groupIdPrefix)
            .kafkaMessageCallback(callback).build();
        kafkaMsgReceiver.startConsumer(config);
    } catch (Exception e) {
        log.error("ini kafkaMsgReceiver start error, topic: {}", TOPIC, e);
    }
}
############
@Slf4j
@Service
public class KafkaMsgReceiver {
    private static final String TAG = "EventReceiver";
    private static final int CONSUMER_POLL_INTERVAL_MS = 1000;

    @Autowired

    private ServerNodeIdDao serverNodeIdDao;

    private volatile boolean stopping;

    public void startConsumer(KafkaConsumerConfig config) throws Exception {
        if (ZKFacade.getZKSettings().getEnvironmentType().equals(EnvironmentType.ONEBOX)) {
            log.warn("dev环境无kafka,不启动");
            return;
        }
        String topic = config.getTopic();
        if (StringUtils.isBlank(topic)) {
            throw new Exception("topic 不能为空");
        }
        KafkaConsumer kafkaConsumer = getConsumer(config);
        new Thread(new Runnable() {
            @Override
            public void run() {
                try {
                    startKafkaConsumer(kafkaConsumer, config);
                } catch (Exception e) {
                    log.error("KafkaMsgReceiver start consumer error", e);
                }
            }
        }, "kafka-receiver-" + topic).start();
    }

    private KafkaConsumer getConsumer(KafkaConsumerConfig config) {
        Properties props = new Properties();
        try {
            props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, config.getKafakaBootstrapServers());
            String groupId = config.getGroupId();
            if ("null".equals(groupId)) {
                String nodeIdStr = "";
                try {
                    nodeIdStr = String.valueOf(serverNodeIdDao.generateNodeID());
                } catch (Exception e) {
                    log.error("{} generateNodeID error", TAG, e);
                    nodeIdStr = "random" + String.valueOf(System.currentTimeMillis());
                }

                groupId = config.getGroupIdPrefix() + "." + nodeIdStr;
                log.info("{} create nodeId: {} groupId: {}", TAG, nodeIdStr, groupId);
            }
            props.put(ConsumerConfig.GROUP_ID_CONFIG, groupId);
            props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "true");
            props.put(ConsumerConfig.AUTO_COMMIT_INTERVAL_MS_CONFIG,
                String.valueOf(CONSUMER_POLL_INTERVAL_MS));
            //这个参数指定了在没有偏移量可提交时(比如消费者第 1 次启动时)或者请求的偏移量在 broker 上不存             //在时(第 4 章已经解释过这种场景),消费者会做些什么。这个参数有两种配置。一种是 earliest,如果选择             //了这种配置,消费者会从分区的开始位置读取数据,不管偏移量是否有效,这样会导致消费者读取大量的重复数             //据,但可以保证最少的数据丢失。一种是 latest,如果选择了这种配置,消费者会从分区的末尾开始读取数               //据,这样可以减少重复处理消息,但很有可能会错过一些消息。
            props.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "latest");
            props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringDeserializer");
            props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringDeserializer");
            return new KafkaConsumer<String, String>(props);
        } catch (Exception e) {
            log.error("init kafaka consumer error", e);
            throw e;
        }
    }

    private void startKafkaConsumer(KafkaConsumer kafkaConsumer,
                                    KafkaConsumerConfig config) {

        KafkaMessageCallback callback = config.getKafkaMessageCallback();
        log.info("KafkaMsgReceiver start");

        kafkaConsumer.subscribe(Arrays.asList(config.getTopic()));
        while (!stopping) {
            ConsumerRecords<String, String> records = kafkaConsumer
                .poll(Duration.ofMillis(CONSUMER_POLL_INTERVAL_MS));
            for (ConsumerRecord<String, String> record : records) {
                try {
                    String msg = record.value();
                    log.info("KafkaMsgReceiver receive msg: " + msg);

                    Event event = CommonUtils.fromJson(msg, Event.class);
                    callback.process(event);
                } catch (Exception ex) {
                    log.error("KafkaMsgReceiver processMsg error", ex);
                }
            }
        }
        kafkaConsumer.close();
    }

    @PreDestroy
    public void stop() {
        log.info(TAG + ".stop");
        stopping = true;
    }
}
kafka只对已提交的消息,作有限度的持久化保证;
acks代表 producer希望leader返回的用于确认请求完成的确认数量. 可选值 all, -1, 0 1. 默认值为1
acks=0不需要等待服务器的确认. 这是retries设置无效. 响应里来自服务端的offset总是-1. producer只管发不管发送成功与否。延迟低,容易丢失数据。acks=1表示leader写入成功(但是并没有刷新到磁盘)后即向producer响应。延迟中等,一旦leader副本挂了,就会丢失数据。acks=all等待数据完成副本的复制, 等同于-1. 假如需要保证消息不丢失, 需要使用该设置. 同时需要设置unclean.leader.election.enable为true, 保证当ISR列表为空时, 选择其他存活的副本作为新的leader.
上述代码的问题:
- 使用的是producer.send(msg),而不是producer.send(msg,callback);这种情况下出现消息丢失,我们是无法知晓的。
log.dirs配置
Kafka 把所有消息都保存在磁盘上,存放这些日志片段的目录是通过 log.dirs 指定的。它是一组用逗号分隔的本地文件系统路径。如果指定了多个路径,那么 broker 会根据“最少使用”原则,把同一个分区的日志片段保存到同一个路径下。要注意,broker 会往拥有最少数目分区的路径新增分区,而不是往拥有最小磁盘空间的路径新增分区。
# A comma separated list of directories under which to store log files
log.dirs=/home/work/kafka/kafka-logs
这个地方的配置存在问题,有条件的话最好保证目录挂载到不同的物理磁盘上。
zookeeper.connect配置
# Zookeeper connection string (see zookeeper docs for details).
# This is a comma separated host:port pairs, each corresponding to a zk
# server. e.g. "127.0.0.1:3000,127.0.0.1:3001,127.0.0.1:3002".
# You can also append an optional chroot string to the urls to specify the
# root directory for all kafka znodes.
zookeeper.connect=zk.c3.xiaomi.srv:5181/mitv/kafka
如果我让多个 Kafka 集群使用同一套 ZooKeeper 集群,那么这个参数应该怎么设置呢?这时候 chroot 就派上用场了。这个 chroot 是 ZooKeeper 的概念,类似于别名。
监听器
监听器的概念,从构成上来说,它是若干个逗号分隔的三元组,每个三元组的格式为<协议名称,主机名,端口号>。这里的协议名称可能是标准的名字,比如 PLAINTEXT 表示明文传输、SSL 表示使用 SSL 或 TLS 加密传输等;也可能是你自己定义的协议名字,比如CONTROLLER: //localhost:9092。
# The address the socket server listens on. It will get the value returned from
# java.net.InetAddress.getCanonicalHostName() if not configured.
#   FORMAT:
#     listeners = listener_name://host_name:port
#   EXAMPLE:
#     listeners = PLAINTEXT://your.host.name:9092
listeners=PLAINTEXT://:9092
advertised.listeners=PLAINTEXT://:9092
不配置链接的是默认的主机
advertised.listeners主要是为外网访问用的。如果clients在内网环境访问Kafka不需要配置这个参数。常见的玩法是:你的Kafka Broker机器上配置了双网卡,一块网卡用于内网访问(即我们常说的内网IP);另一个块用于外网访问。那么你可以配置listeners为内网IP,advertised.listeners为外网IP。
Topic 管理
- auto.create.topics.enable:是否允许自动创建 Topic。最好为false,否则会有千奇百怪的topic出现;
- unclean.leader.election.enable:是否允许 Unclean Leader 选举。 false,坚决不能让那些落后太多的副本竞选 Leader;
- auto.leader.rebalance.enable:是否允许定期进行 Leader 选举。false,原本向 A 发送请求的所有客户端都要切换成向 B 发送请求,而且这种换 Leader 本质上没有任何性能收益,因此我建议你在生产环境中把这个参数设置成 false。
数据留存
- log.retention.{hours|minutes|ms}:这是个“三兄弟”,都是控制一条消息数据被保存多长时间。从优先级上来说 ms 设置最高、minutes 次之、hours 最低。
- log.retention.bytes:这是指定 Broker 为消息保存的总磁盘容量大小。
- message.max.bytes:控制 Broker 能够接收的最大消息大小。可以设置的大一点