一个简单的假设
例子:
正文: …….
模式字符串: B A A A A
其中,正文长度为N,模式字符串长度为M,一般来说N>>M。
我们先来做一个假设,假设正文中仅有A和B两个字符组成。那么如果第五个字符匹配失败,可知正文对应部分肯定为B A A A B。那么此时,我们没有必要去回退文本指针i,因为正文对应部分的第2-4个字符均为A,都和模式字符串的第一个字符B不相匹配。这时我们可以直接将i加1,以比较文本的下一字符和模式字符串中的第二个字符。这样我们最多仅仅会进行N次字符串比较。这样我们最多仅仅会进行N次字符串比较。上述情况是很特殊的,但其思想是值得思考的,那么我们可以将这种思想抽象化以使得其可以适用于所有情况吗?
暴力求解法如图所示:
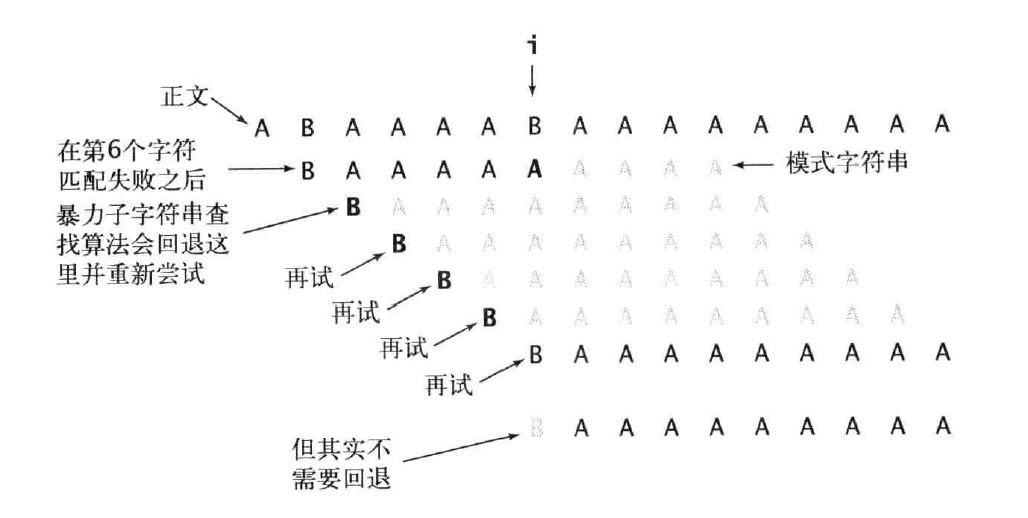
可以看到,上述暴力算法中,很多指针i的移动时没有必要的。为了提升字符串匹配算法的性能,我们将介绍一个经典的且令人印象深刻的算法:Knuth-Morris-Pratt算法。
KMP算法的创新
在介绍KMP算法的具体实现之前,先来介绍KMP算法的创新之处:
当出现不匹配时,就能知晓一部分文本的内容,可以利用这些信息避免讲指针回退到所有这些已知的字符之前。
此算法的通用性令人印象深刻:在匹配失败时从能将模式字符串指针j设置为某个值以使文本指针i不回退
(if the beginning part of a string is appearing again somewehere else in the string then don’t again compare the characters right avoid the comparison and don’t move i back again like it was happening in basic algorithm.)
详细介绍KMP算法
下面,我们会从前缀和后缀的角度来详细讲解KMP算法。
对于一个模式字符串“ abcdabc ”来说,其前缀和后缀分别为:
prefix:a,ab,abc,abcd,abcda,abcdab
suffix:c,bc,abc,dabc,cdabc,bcdabc
对于这个字符串来说,其前缀和后缀中都有“abc”,即“abc”这个子字符串重复出现了。
为了记录这种重复性,生成一个数组。对于这个数组,我们称之为LPS(longest prefix which is same as some suffix)
下面举几个例子来说明LPS中的值怎么根据模式字符串来生成。
- a b c d a b e a b f
0 0 0 0 1 2 0 1 2 0(LPS) - a b c d e a b f a b c
0 0 0 0 0 1 2 0 1 2 3(LPS)
在得到了LPS数组后,KMP算法的后续工作也就比较简单了。下面我们将从一个例子入手,去介绍剩下的过程。
tex: a b a b c a b c a b a b a b d
pattern: a b a b d
根据模式字符串pattern,我们得到LPS数组为:-1 0 0 1 2 0 (在最前面设为-1是为了编程方便,也可以不加)
设指向tex的指针为i,指向pattern的指针为j。
当i指向5,j指向5的时候,字符不匹配,根据LPS数组来回退j。此时LPS的第j个值为2,所以j回退到2,i不变,继续比较。字符仍不匹配,j回退到0,i不变,继续比较。重复上述过程,即可得到最后的匹配结果。
具体的代码实现:
private int[] getNext(String pattern) {
    int j = 0;
    int k = -1;
    int len = pattern.length();
    int []next = new int[len+1];
    next[0] = -1;

    while (j < len - 1) {
        if (k == -1 || pattern.charAt(k) == pattern.charAt(j)) {
            ++k;
            ++j;
            next[j] = k;
        } else {
            k = next[k];
        }
    }
    return next;
}
private int kmp(String tex, String pattern) {
    int tlen = tex.length();
    int plen = pattern.length();
    int []next = getNext(pattern);
    int i=0,j=0;
    while(i<tlen && j<plen){
        if(tex.charAt(i)==pattern.charAt(j)){
            ++i;
            ++j;
        } else{
            if(next[j]==-1){
                ++i;
                j=0;
            }else {
                j = next[j];
            }
        }
        if(j==plen) return i-j;
    }
    return -1;
}
暴力匹配的代码实现:
int strStr1(String haystack, String needle) {
       char []arrays = haystack.toCharArray();
       char []mapp = needle.toCharArray();
       if(mapp.length==0 && arrays.length==0)
           return 0;
       if(mapp.length==0)
           return 0;
       if(arrays.length==0 || arrays.length<mapp.length)
           return -1;
       int flag = 0;
       for(int i=0;i<arrays.length;i++){
           if(arrays[i]==mapp[0]){
               flag = 0;
               int k = i;
               for(int j=0;j<mapp.length;j++){
                   if(k<arrays.length && arrays[k]==mapp[j] ){
                       ++k;
                       ++flag;
                   }
                   else{
                       break;
                   }
               }
               if(flag == mapp.length){
                   return i;
               }
           }
       }
       return -1;
   }
时间复杂度:
KMP为O(m+n)
暴力匹配为O(mn)
其中,m为tex长度,n为pattern长度。